Yapay zekâ aramalarında görünmek: ChatGPT, Gemini ve Perplexity'de kaynak olmak
Yapay zekâ aramalarında görünmek için sitenin önce arama motorlarında dizinde olması, yapay zekâ botlarına kapıyı açması ve soruya ilk cümlede net cevap veren içerik yayınlaması gerekir. Soru biçimli başlıklar, birinci el bilgi, yazar ve tarih, yapısal veri ve llms.txt yardımcı olur. Kimse kaynak gösterilmeyi garanti edemez, ama bu adımlar şansı artırır.
Yapay zekâ aramalarında görünmek ne demek?
Yapay zekâ aramalarında görünmek, ChatGPT, Gemini, Perplexity ya da Google'ın yapay zekâ özetleri bir soruya cevap verirken sitenizin kaynak olarak gösterilmesi demektir. Kullanıcı on mavi link yerine yazılı bir cevap okur. Cevabın altında ya da içinde birkaç kaynak linki olur. Hedef, o linklerden biri olmaktır.
Bu işe GEO (üretken arama motoru optimizasyonu) ya da AEO (cevap motoru optimizasyonu) deniyor. Adlar yeni, ama temelin büyük kısmı eskidir. Yapay zekâ araçları cevap yazarken çoğu zaman bir arama dizininden sayfa çeker. O sayfayı okur, işine yarayan cümleyi alır ve kaynağı gösterir.
Bu yazıda neyin işe yaradığını ve neyin abartıldığını anlatıyoruz. Kendi sitemizde uyguladıklarımızı da örnek olarak veriyoruz.
Yapay zekâ araçları kaynaklarını nasıl seçer?
Yapay zekâ araçları kaynaklarını büyük ölçüde bir arama dizininden seçer, sonra soruya en net cevap veren sayfaları alıntılar. Hangi dizini kullandıkları ve nasıl sıraladıkları platformdan platforma değişir ve tam olarak açıklanmaz.
Bilinenler şunlardır. Google'ın yapay zekâ özetleri Google Arama'nın parçasıdır ve aynı dizini kullanır. Google, bu özelliklerde görünmek için ayrı bir işlem gerekmediğini, normal SEO kurallarının geçerli olduğunu söyler. ChatGPT arama özelliği için OpenAI'ın OAI-SearchBot adlı botu siteleri tarar. Perplexity kendi PerplexityBot botuyla dizin oluşturur. Kullanıcı bir linki doğrudan açtırdığında ise ChatGPT-User ya da Perplexity-User gibi ayrı ajanlar sayfayı çeker.
Buradan çıkan ilk sonuç açıktır: sayfanız arama motorlarında dizinde değilse, yapay zekâ cevabında da büyük ihtimalle yoktur. Teknik temeli SEO uyumlu web sitesi nasıl olmalı yazısında anlattık. Bu yazıdaki her şey onun üzerine kurulur.
İçerik nasıl yazılırsa alıntılanır?
Alıntılanan içerik, soruyu başlıkta soran ve ilk cümlede cevaplayan içeriktir. Yapay zekâ uzun bir sayfanın tamamını değil, soruya karşılık gelen bir ya da iki cümleyi alır. O cümle tek başına anlamlı olmalıdır.
- Soru biçimli başlık: "Fiyat" değil, "Web sitesi fiyatı neye göre belirlenir?" İnsanların yapay zekâya yazdığı cümleye benzer.
- İlk cümlede cevap: Başlığın hemen altındaki cümle cevabı söyler. Arka plan, örnek ve ayrıntı sonra gelir.
- Kendi başına anlamlı paragraf: "Yukarıda dediğimiz gibi" ile başlayan bir cümle alıntılanınca anlamsız kalır.
- Somut bilgi: Sayı, süre, eşik değer, adım. "Hızlı olmalı" yerine "ana içerik 2,5 saniye içinde görünmeli".
- Liste ve tablo: Karşılaştırma ve adımlar, düz metne göre daha kolay ayrıştırılır.
- Sayfa başında özet: İki üç cümlelik bir özet ya da madde listesi, sayfanın ne cevapladığını baştan gösterir.
Bu yazı da bu kurala göre yazıldı. Her ara başlık bir soru, her bölümün ilk cümlesi o sorunun cevabı.
Birinci el bilgi neden bu kadar önemli?
Birinci el bilgi önemlidir, çünkü yapay zekâ aynı genel bilgiyi yüz sitede bulabilir, ama sizin deneyiminizi sadece sizin sitenizde bulur. Kaynak olarak gösterilmenin en sağlam yolu, başka yerde olmayan bir şey söylemektir.
Birinci el bilgi şunlar olabilir: kendi sürecinizin adımları, kendi ölçümleriniz, sık karşılaştığınız bir sorun ve çözümü, müşterilerin gerçekten sorduğu sorular. Örneğin biz tekliflerimizin tek sayfa olduğunu, bitiş tanımının ilk gün imzalandığını ve teslimden sonra 30 gün hataları ücretsiz düzelttiğimizi yazıyoruz. Bu bilgi başka bir sitede yoktur.
Bunun yanında sayfada kimin yazdığı ve ne zaman güncellendiği görünmelidir. Yazar adı, firmanın adresi, iletişim bilgisi ve güncel tarih, içeriğin arkasında gerçek biri olduğunu gösterir. Google'ın yardımcı içerik rehberi de deneyim, uzmanlık ve güvenilirlik sinyallerini ayrıca vurgular.
Yapısal veri yapay zekâ aramalarında işe yarar mı?
Yapısal veri dolaylı olarak işe yarar: sayfanın ne olduğunu, kimin yazdığını ve ne zaman güncellendiğini makinenin yanlış anlamayacağı biçimde söyler. Yapay zekâ platformlarının yapısal veriyi nasıl kullandığı tam açıklanmaz, ama arama dizinleri onu okur.
Yazılar için Article türü yazar ve tarih bilgisini taşır. Firma için Organization türü ad, adres ve iletişim bilgisini taşır. Sık sorulan sorular için FAQPage, adımlar için HowTo kullanılabilir. Yapısal veri her zaman sayfada görünen bilgiyle aynı olmalıdır.
llms.txt nedir ve gerçekten gerekli mi?
llms.txt, sitenin kökünde duran ve yapay zekâ modellerine sitenin kısa bir özetini ve önemli sayfaların listesini veren Markdown dosyasıdır. 2024'te önerilmiş bir biçimdir. Resmî bir standart değildir.
Dürüst olmak gerekirse, büyük yapay zekâ arama platformlarının llms.txt dosyasını sıralama için okuduğunu açıkça söyleyen bir belge yok. Google da yapay zekâ özellikleri için özel bir dosya gerekmediğini söylüyor. Yine de dosya ucuzdur, bir kez kurulur ve kendiliğinden güncellenir. Kod yazan araçlar ve bazı ajanlar tarafından okunduğu biliniyor. Biz bu yüzden ekliyoruz, ama kimseye "llms.txt ile yapay zekâda çıkarsınız" demiyoruz.
Hangi botlara izin vermek gerekir?
Yapay zekâ aramalarında görünmek istiyorsanız, arama için sayfa çeken botlara robots.txt içinde izin vermeniz gerekir. Model eğitimi için içerik toplayan botlar ise ayrı bir karardır ve onları engellemek genellikle arama görünürlüğünü etkilemez.
- OAI-SearchBot: ChatGPT arama sonuçları için siteleri tarar. Engellenirse site ChatGPT arama cevaplarında gösterilmeyebilir.
- ChatGPT-User: Kullanıcı ChatGPT'den bir sayfayı açmasını istediğinde çalışır.
- GPTBot: OpenAI'ın model eğitimi için kullandığı bottur. OpenAI'ın belgesine göre arama botundan ayrı yönetilir.
- PerplexityBot ve Perplexity-User: Perplexity'nin dizin botu ve kullanıcı adına sayfa çeken ajanı.
- Claude-SearchBot, Claude-User, ClaudeBot: Anthropic'in arama, kullanıcı isteği ve eğitim botları.
- Google-Extended: Ayrı bir bot değil, robots.txt belirtecidir. İçeriğin Gemini modellerinin eğitimi ve cevaplarında kullanılmasını kontrol eder. Google'a göre Google Arama'daki görünürlüğü ve sıralamayı etkilemez. Arama'daki yapay zekâ özetleri ise Googlebot kurallarına bağlıdır.
Sık görülen hata, "yapay zekâ botlarını engelle" diye hazır bir liste kopyalayıp arama botlarını da kapatmaktır. Site böylece ChatGPT ve Perplexity cevaplarından kendi eliyle çıkar. Her botun ne yaptığını platformun kendi belgesinden okuyun ve kararı bot bot verin.
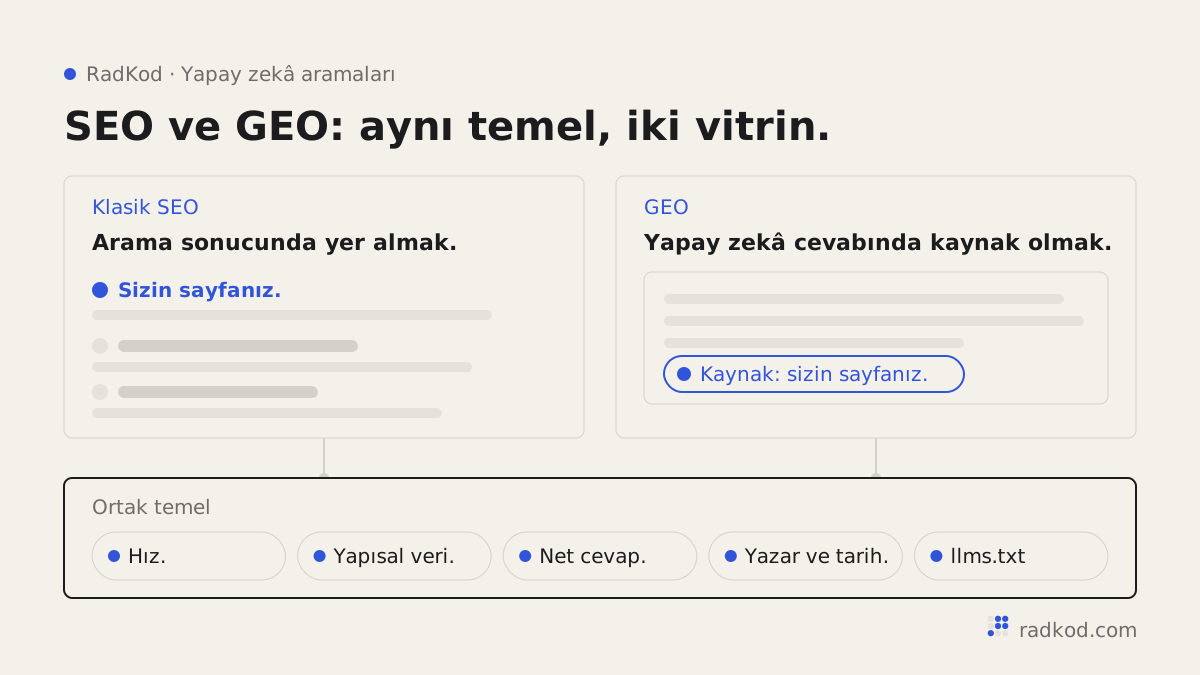
| Konu | Klasik SEO | Yapay zekâ aramaları (GEO) |
|---|---|---|
| Sonuç | Sıralı link listesi | Yazılı cevap ve birkaç kaynak linki |
| Hedef | Üst sıralarda görünmek ve tıklanmak | Cevapta kaynak olarak gösterilmek |
| Birim | Sayfa | Sayfanın içindeki cümle ya da paragraf |
| İçerik biçimi | Konuyu kapsayan sayfa | Soru biçimli başlık, ilk cümlede cevap, kendi başına anlamlı paragraf |
| Botlar | Googlebot, Bingbot | Bunlara ek olarak OAI-SearchBot, PerplexityBot, Claude-SearchBot |
| Ölçüm | Search Console, sıralama ve tıklama | Sınırlı. Yapay zekâ kaynaklı ziyaretler ve bot kayıtları izlenebilir |
| Ortak temel | Hız, dizine girme, yapısal veri, güvenilirlik, yardımcı içerik | Aynı temel |
RadKod sitesi bunları nasıl uyguluyor?
Kendi sitemizde bu yazıda anlatılan her şeyi kodla, kendiliğinden çalışacak şekilde kurduk. Bunu örnek olsun diye anlatıyoruz. Sonuç garantisi olarak değil.
- llms.txt ve llms-full.txt: Kök adreste sitenin özeti ve önemli içeriklerin listesi durur. llms-full.txt dahil edilen tüm içeriklerin Markdown metnini tek dosyada verir. Yeni içerik yayınlanınca ikisi de kendiliğinden güncellenir.
- İçerik başına Markdown: Her yazının, hizmet sayfasının ve sözlük teriminin adresinin sonuna .md eklenince sayfanın düz Markdown hali açılır. Bu sürüm asıl sayfayı kanonik olarak gösterir, yani arama motoru için kopya içerik oluşturmaz.
- Bot politikası: robots.txt kuralları botları üç gruba ayırır: klasik arama, yapay zekâ araması ve model eğitimi. Her grubun izni yönetim panelinden ayrı ayrı açılıp kapanır.
- Bot ziyaret kaydı: Hangi botun hangi sayfayı ne zaman ziyaret ettiği kaydedilir. Böylece bir yapay zekâ botunun sitemize gelip gelmediğini tahmin etmeden görürüz.
- Yapısal veri: Her sayfa firma, yazı, sayfa yolu ve sık sorulan sorular bilgisini tek bir yapısal veri grafiğinde taşır.
- İçerik yapısı: Yazılar özet maddeleriyle başlar, ara başlıklar soru biçimindedir, her bölümün ilk cümlesi cevaptır, sonda kaynaklar listelenir.
Bu altyapıyı müşteri sitelerine de kuruyoruz. Kapsamı web tasarım ve kurumsal web sitesi sayfasında görebilirsiniz.
Yapay zekâ aramalarında görünmek için adım adım
- 01 Dizinde olduğunuzu doğrulayın Search Console ve Bing Webmaster Tools ile önemli sayfalarınızın dizinde olduğunu kontrol edin. Dizinde olmayan sayfa yapay zekâ cevabına da giremez.
- 02 robots.txt dosyasını okuyun OAI-SearchBot, PerplexityBot ve Claude-SearchBot gibi arama botlarının engellenmediğinden emin olun. Eğitim botları için ayrı karar verin.
- 03 Müşterilerinizin sorularını toplayın Telefonda, e-postada ve toplantıda sorulan soruları yazın. Her biri bir ara başlık ya da bir yazı olabilir.
- 04 Başlıkları soru, ilk cümleleri cevap yapın Önemli sayfalardan başlayarak her bölümü bu kurala göre yeniden düzenleyin.
- 05 Birinci el bilgi ekleyin Kendi sürecinizi, ölçümlerinizi ve örneklerinizi yazın. Yazar adını ve güncelleme tarihini görünür yapın.
- 06 Yapısal veriyi ve llms.txt dosyasını kurun Article, Organization ve FAQPage işaretlemesini ekleyin. llms.txt dosyasını kodla üretin ki içerik değişince güncel kalsın.
- 07 Kendiniz sorun ve izleyin Müşterilerinizin soracağı soruları ChatGPT, Gemini ve Perplexity'ye düzenli sorun. Kimin kaynak gösterildiğine bakın. Sunucu kayıtlarından bot ziyaretlerini izleyin.
Yapay zekâ aramalarında görünmek garanti edilebilir mi?
Hayır, kimse yapay zekâ cevaplarında kaynak gösterilmeyi garanti edemez. Aynı soru iki kez sorulduğunda farklı kaynaklar gösterilebilir. Platformlar kaynak seçme yöntemlerini tam açıklamaz ve sık değiştirir.
Bu yüzden "sizi ChatGPT'de ilk sıraya çıkarırız" diyen bir teklife temkinli yaklaşın. Yapılabilecek şey, şansı artıran temeli kurmak ve düzenli içerik üretmektir. Ölçüm de sınırlıdır. Analiz aracınızda chatgpt.com ya da perplexity.ai gibi kaynaklardan gelen ziyaretleri ayrı görebilirsiniz, ama cevapta adınızın geçtiği her durumu göremezsiniz.
İyi haber şu: bu yazıdaki adımların hiçbiri sadece yapay zekâ için değildir. Soruya net cevap veren, hızlı açılan, kimin yazdığı belli olan sayfa, klasik aramada da iyi sonuç verir. Hızı düzeltmek için site hızı ve Core Web Vitals, sayfa listesi için kurumsal sitede olması gereken sayfalar yazılarına bakabilirsiniz. Mevcut sitenizi yeniliyorsanız önce site yenilerken SEO yazısını okuyun.
Sık sorulanlar
GEO ile SEO aynı şey mi?
Tamamen değil, ama büyük ölçüde örtüşür. SEO sıralı link listesinde görünmeyi, GEO yazılı cevapta kaynak gösterilmeyi hedefler. İkisi de hız, dizine girme, güvenilirlik ve soruya cevap veren içerik üzerine kurulur.
Google'ın yapay zekâ özetlerinde görünmek için ayrı bir şey yapmak gerekir mi?
Google'a göre hayır. Yapay zekâ özetleri Google Arama'nın parçasıdır ve normal SEO kuralları geçerlidir. Sayfanın dizinde olması ve metin içeriğinin taranabilir olması gerekir.
GPTBot'u engellersem ChatGPT'de görünmez miyim?
OpenAI'ın belgesine göre GPTBot eğitim içindir, ChatGPT arama sonuçları için OAI-SearchBot kullanılır. İkisi ayrı ayrı yönetilir. GPTBot'u engelleyip OAI-SearchBot'a izin verebilirsiniz.
Google-Extended'ı engellemek Google sıralamamı düşürür mü?
Google'ın belgesine göre hayır. Google-Extended, içeriğin Gemini modellerinde kullanılmasını kontrol eder ve Google Arama'daki sıralamaya etkisi yoktur.
llms.txt eklersem yapay zekâda çıkar mıyım?
Bunun garantisi yok. llms.txt resmî bir standart değildir ve büyük arama platformları sıralama için kullandığını açıklamamıştır. Kurulumu ucuz olduğu için eklemek zararsızdır, ama tek başına sonuç beklemeyin.
Küçük bir firma sitesi yapay zekâ cevaplarında kaynak olabilir mi?
Evet. Özellikle dar ve somut sorularda büyük sitelerden çok, soruyu en net cevaplayan sayfa alıntılanır. Yerel hizmet, süreç ve fiyat etkenleri gibi konularda birinci el içerik büyük avantajdır.
Yapay zekâ ile yazılmış içerik alıntılanır mı?
İçeriğin nasıl yazıldığı değil, ne kadar yardımcı ve doğru olduğu önemlidir. Ama başka sitelerdeki genel bilgiyi yeniden yazan içerik, yapay zekâ için yeni bir şey taşımaz. Birinci el bilgi eklenmezse alıntılanma nedeni yoktur.
Yapay zekâdan gelen ziyaretleri nasıl ölçerim?
Analiz aracınızda yönlendiren siteler listesinde chatgpt.com, perplexity.ai ve gemini.google.com gibi kaynaklara bakın. Sunucu kayıtlarında da yapay zekâ botlarının ziyaretlerini görebilirsiniz. Cevapta adınızın geçip geçmediğini ise ancak soruları kendiniz sorarak görürsünüz.
Kaynaklar
- 01 AI features and your website · Google Search Central
- 02 Overview of Google crawlers and fetchers · Google Search Central
- 03 Creating helpful, reliable, people-first content · Google Search Central
- 04 Overview of OpenAI Crawlers · OpenAI
- 05 Perplexity Crawlers · Perplexity
- 06 The /llms.txt file · llmstxt.org
- 07 Schema.org · Schema.org